Evaluierung Ingest Optionen
Einleitung
Der Data Ingest Layer ist die entscheidende Komponente der Datenfabrik, die für die Erfassung und Integration von Daten aus verschiedenen Quellen verantwortlich ist. Dieser Layer stellt sicher, dass Daten zuverlässig und effizient in die Datenfabrik gelangen, um für weitere Verarbeitungsschritte bereitgestellt zu werden. Folgende Kriterien müssen für diese Architekturelle Entscheidung beachtet werden (auf Basis der Anforderungen).
Außerdem beziehen sich die meisten Softwarelösungen auf mehrere technische Komponenten (etwa Workflow Orchestrator + ETL).
Kriterien für eine Architekturentscheidung
Nr 1: Konnektivität zu Datenquellen
Der Data Ingest Layer muss eine breite Palette von Datenquellen unterstützen, einschließlich:
- Datenbanken: Relationale (z.B. MySQL, PostgreSQL) und NoSQL (z.B. MongoDB).
- Flat Files: CSV, JSON, XML.
- Cloud-Speicher: S3 / Object Storage
- Streaming-Plattformen: Apache Kafka
Nr 2: Datenextraktion
- zuverlässige Extraktionsmechanismen für jede unterstützte Datenquelle.
- Behandlung von Teilausfällen, um die Datenkonsistenz und -integrität zu gewährleisten.
- Optionen für eine vollständige oder inkrementelle Extraktion auf der Grundlage der Anforderungen an die Datenaktualität.
Nr 3: Datenumwandlung / Transformation
- Transformations-Framework: Ein flexibles und erweiterbares Framework, das benutzerdefinierte Transformationen ermöglicht.
- Datenverarbeitungsoperationen: Unterstützung gängiger Operationen wie Filter, Aggregate, Joins und Fensterfunktionen.
- Idempotenz: Sicherstellung, dass Transformationen idempotent sind, um eine erneute Verarbeitung ohne Nebeneffekte zu ermöglichen.
Nr 4: Datenüberprüfung
- Validierung: Überprüfung der Daten anhand vordefinierter Schemata.
Nr 5: Serialisierung und Deserialisierung von Daten
- Unterstützte Formate: JSON, Avro, Parquet, CSV.
- Optimierung: Effiziente Serialisierung und Deserialisierung im Hinblick auf Leistung und Speicher.
Nr 6: Erweiterbarkeit und Anpassbarkeit
- Benutzerdefinierte Module: Möglichkeit zur Integration benutzerdefinierter Module oder Skripte.
- UDFs und UDAFs: Unterstützung benutzerdefinierter Funktionen und Aggregationen für erweiterte Transformationen.
Nr 7: Überwachung der Datenqualität
- Datenqualitätsprüfungen: Implementierung von Prüfungen und Metriken zur Überwachung der Aktualität, Vollständigkeit und Konsistenz.
- Benachrichtigungen: Mechanismen zur Benachrichtigung bei Datenqualitätsproblemen und zur Abhilfe.
Nr 8: Gleichzeitigkeit und Parallelverarbeitung
- Multi-Threading
- Ressourcenmanagement: Gewährleistung von Thread-Sicherheit und effizientem Ressourcenmanagement.
Nr 10: Fehlertoleranz und Wiederholungsmechanismen
- Fehlertoleranz: Implementierung fehlertoleranter Designprinzipien.
- Wiederholungsmechanismen: Konfigurierbare Wiederholungsmechanismen mit exponentiellem Backoff und Jitter.
Nr 11: Skalierbarkeit und Leistung
- Horizontal skalierbar
- Datenpartitionierung, Komprimierung und effiziente Datenspeicherung
- Queues
Nr 12: Monitoring und Logging
- Alarmierung bei Ausfällen, Daten-Verschlechterungen, Ressourcenmanagement etc.
Nr 13: Versionierung und Rückwärtskompatibilität
- Versionierung für Datenquellen, Schemata und Transformationen, um die Abwärtskompatibilität zu gewährleisten.
Nr. 14: Betrieb in gemeinsamer Kubernetes Umgebung
- Mandantentrennung
- Einfacherer Betrieb der laufenden Anwendung bei hinzufügen neuer Pipelines
- Existierende Helm Charts / Einfaches Deployment
Optionen
Folgende Optionen standen vor Projektstart im Raum und sollen evaluiert werden:
- NiFi
- Airflow
- Airbyte
- Windmill
- MageAI
- Argo (https://argoproj.github.io/workflows/)
- Dagster (https://dagster.io/)
Übersicht Bewertung der Optionen
Aus den o.g. grundlegenden Anforderungen sollen nun wesentliche Feature-Merkmale herausgegriffen werden anhand derer eine Bewertung stattfinden kann.
Im Zuge dieser Bewertung wurden die Tools als lokale Container getestet sowie Fachforen und Fachartikel zu Rate gezogen.
Bewertungs-Matrix
Bewertung zwischen 0 (erfüllt 0%) und 1 (erfüllt 100%)
- (in 0,2 Schritten)
| Tool Name → | Apache NiFi | Apache Airflow | Airbyte | Windmill | Argo Workflows | Dagster | MageAI |
|---|---|---|---|---|---|---|---|
| Kriterium ↓ | |||||||
| Entstehungsjahr / Reife | (2006/2014) 1 |
(2015) 1 |
(2020) 0,6 |
(2023) 0,2 |
(2018) 1 |
(2019) 0,8 |
(2022) 0,2 |
| Marktanteil (absolute Summe GitHub Stars) (Score = Absolute Stars / Maximale Stars) |
5.300 0,13 |
39.700 1,00 |
17.900 0,45 |
12.800 0,32 |
15.500 0,39 |
13.000 0,33 |
8.300 0,21 |
| Vollständig OpenSource VS. Community Edition Beschränkungen | 1 | 1 | 0,8 | 0,6 | 1 | 0,8 | 0,8 |
| Unterstützt das DAG Konzept | 0 | 1 | 0 | 0,6 | 1 | 1 | 0,6 |
| Kubernetes / Helm Support | 0,5 | 1 | 1 | 1 | 1 | 1 | 1 |
| Isolation / Multi-Mandantenfähigkeit (Trennung Container Runner/Worker) | 0 | 1 | 0,6 | 0,8 | 0,6 | 1 | 0,6 |
| Visuelle Oberfläche (subjektive Bewertung) | 1 | 0,8 | 1 | 0,6 | 0,6 | 0,8 | 0,8 |
| Breite Datenquellen-unterstützung | 1 | 1 | 1 | 0,8 | 0,8 | 1 | 0,8 |
| Pipeline/DAG as Code | 0,4 | 1 | 0,6 | 1 | 1 | 1 | 1 |
| Data Engineer Ökosystem | 0,2 | 1 | 0,2 | 1 | 0,6 | 1 | 0,8 |
| Streaming | 1 | 0,4 | 0,4 | 0,6 | 0,6 | 0,6 | 0,6 |
| Monitoring | 0,6 | 1 | 0,6 | 0,6 | 0,6 | 0,8 | 0,8 |
| Skalierbarkeit | 0,6 | 0,8 | 0,8 | 1 | 0,8 | 0,8 | 0,6 |
| Enterprise Support möglich? | |||||||
| SUMME | 7,43 | 12 | 8,05 | 9,12 | 9,99 | 10,93 | 8,81 |
Bewertungs-Matrix (Beschreibung)
| Tool Name → | Apache NiFi | Apache Airflow | Airbyte | Windmill | Argo Workflows | Dagster | MageAI |
|---|---|---|---|---|---|---|---|
| Kriterium ↓ | |||||||
| Alleinstellungsmerkmal | - Fokus auf Verschieben von Daten von A nach B mit Fokus auf Schnelligkeit und Effizienz - Fokus auf visuelle Darstellung |
- Sehr hohe Verbreitung am Markt / Industriestandard - DAG as Code - Orchestrierung & Python - Kann beliebig komplexe Pipelines und Anforderungen abbilden |
- Stärker bei SaaS Connectoren - Gut für einfache visuelle Extraktionen - Fokus mehr auf Datenbewegung und weniger auf "komplexe Pipelines" |
- DAG + Code Kombination => Starker Fokus auf Code - Flowbestandteile => Einzelne Scripts (Bash, Python) - Windmill AI Unterstützt hier => self-hosted Usage (?) - Windmill App UI Editor |
- Gut integriebar in ArgoCD DevOps Welt - k8s nativ |
- Aktuell aufstrebend in Data Engineering Szene (viel gelesen in e.g. reddit) - Data Processing fokussiert sich hier mehr innerhalb Dagster - DAG / Taskablauf nicht "hard-coded" wie etw Airflow |
- Jupyter Notebook artige UI - UI basiertes Drag-and-Drop der Workflows / DAGs |
| Marktanteil (absolute Summe GitHub Stars) (Punkte Platzierung) |
Etabliert für IoT, Streaming, Eher Nischenlösung | Weit verbreitet in Enterprise & Cloud | Stark wachsend, viele Integrationen | Sehr junges Projekt, aber schnell wachsend | Bekannt im K8s-Cloud-Native-Umfeld, wachsend | Moderne Teams & Data Engineers setzen vermehrt darauf.. | Eindruck ist eher für kleine Teams gedacht (ggf. harter als Platform maintainbar) |
| Vollständig OpenSource VS. Community Edition Beschränkungen | Vollständig Open Source (Apache 2.0) | Vollständig Open Source (Apache 2.0) | Core ist OSS, aber manche Features (z. B. orchestrierter Scheduler, OAuth nur in Enterprise/Cloud Editon | OSS Core, aber deutlich mehr Features nicht in Community Edition drin bspw. Audit Logs, RBAC | Vollständig Open Source (Apache 2.0) | OSS Core stark, aber ein paar Einschränkungen im Asset Catalog und Auth-Setup (!) https://docs.dagster.io/dagster-plus/ |
|
| Unterstützt das DAG Konzept | Nur EL Datenflussdiagramme | Vollständig DAG-basiert | Eher E und L Fokus, aber nicht klassisch DAG Struktur | TTasks können in Sequenz & parallel geplant werden (unklar ob Vor- oder Nachteil..) | DAG als YAML (Argo "Stil") | Asset-based DAGs (anderer Ansatz der Trigger als das task-orientierte Airflow) | Nicht primär nach DAG definition |
| Kubernetes / Helm Support | möglich aber aufwändiger als andere Optionen | Komplexeres Deployment Modell => Dagster behandelt jedes Projekt (eg ein DAG) als eine eigenständige Applikation/Container, die per gRPC in eine zentrale Dagster-Instanz eingebunden wird. |
|||||
| Isolation / Multi-Mandantenfähigkeit (Trennung Container Runner/Worker) | Datenflüsse getrennt, aber nicht direkt klar, ob bspw. eigene Container laufen lassen können | Executor Strategie mit Kubernetes API als eigenen Container/Pod => ausgereift | Workspace Erstellung möglich und UI Nutzertrennung. Pod Isolation auch möglich (aber nur Enterprise ONLY) | Windmill arbeitet mit "Workspaces" / Executor Deployment anpassbar, aber nicht nativ gegeben | Code Locations Konzept => Eigene Pods/Jobs möglich | Keine Runtime trennung by default, aber Workspace Trennung für Teams |
|
| Visuelle Oberfläche (subjektive Bewertung) | |||||||
| Breite Datenquellen-unterstützung | ja | ja sehr viele Operatoren | ja, vor allem auch zu SaaS Dienste | ja, aber eher Script-basiert und nicht nativ | ja, einige Connectoren ggf. nicht ganz so ausgereift vgl. zu Airflow | ||
| Pipeline/DAG as Code | UI-Fokus, XML-basiert, eingeschränkt Push-to-Code | Python DAG, Integration, CI/CD tauglich | JSON-basierte Pipeline-Def., eingeschränkter Codefluss (Terraform möglich) | Python/YAML-basierte Tasks, Scripts direkt ausführbar | YAML-Workflows, sehr CI/CD-freundlich | Python-DAGs, moderne Patterns | |
| Data Engineer Ökosystem | Wenig (kein Pandas o.ä., eher Low-Code GUI Fokus) | Stark – native Python-Nutzung, Pandas, Jupyter | Teilweise – Python nutzbar, aber wenig Data Engineering Code | ja – Python-Snippets, Pandas, SQLite, ML-Tools direkt möglich | Schwach – eher für DevOps/CI, nicht speziell Data Engineers | Ja – Pandas, DataFrames, MLflow etc. gut integrierbar | |
| Streaming | Für Batchjobs ausgelegt | Für Batchjobs ausgelegt | möglich via Scripting, Triggers, | Für Batchjobs ausgelegt | |||
| Monitoring | Wenig Basis Monitoring und Alerts | In Airflow selbst Übersicht über Jobs, aber auch durch hohe Marktbreite Charts für e.g. Grafana | Logs vorhanden und Metrics über OpenTelemetry sammelbar (aber extern nötig) | Audit Logs gibt's nicht in der OSS-Variante, sondern nur mit dem "Enterprise Plan" s. https://www.windmill.dev/docs/core_concepts/audit_logs | Run-Logs, Audit-Trails, Prometheus & Event Logs verfügbar | ||
| Skalierbarkeit | Cluster-Modus, aber Tendenz weniger Partitionierung / Verteilungsmöglichkeiten / Komplexeres Setup | Kubernetes und Celery Executor für Skalierbarkeit ausgelegt; Seperate Queues möglich | Skalierbarkeit eher auf Connector Ebene weniger auf Task Ebene | Laut Benchmarks schneler als Airflow und hoch-skalierbar bis 1000 Workern (https://www.windmill.dev/blog/launch-week-1/fastest-workflow-engine) | k8s-nativ skalierbar s. https://www.freecodecamp.org/news/set-up-argo-workflows-on-kubernetes/ | ||
| Enterprise Support möglich? |
Zusammenfassung Bewertung / Ausschluss von Tools
- Geringere Reife / Marktausbreitung in Kombination mit Unklarheit über OSS Strategie Entwicklung der dahinterstehenden Firmen => Wird daher nicht in Betracht gezogen
- Windmill
- MageAI
- Argo Workflows reiht sich in Argo Toolchain ein. Da diese aktuell nicht angepeilt ist, wird Argo Workflows erstmals depriorisiert
Evaluierung
Alle oben-genannten Tools sind im ETL/ELT Umfeld etabliert und haben Vor- und Nachteile in ihren jeweiligen ETL/ELT Prozessschritten sowie in ihrem Design (Code-based, UI-based, Deployment-Möglichkeiten). Für eine erste Architekturentscheidung ist es sinnvoll sich auf wenige, aber etablierte Tools zu beschränken und hierbei sowohl einen großen Funktionsumfang, aber auch "einfach-bedienbare" Optionen (für simple Use Cases) mit einzubeziehen.
Es lassen sich die folgenden drei Kern-Einsatzgebiete für Tools ableiten:
ETL/ELT Orchestrator
- Bietet eine ausgereifte und flexible Orchestrierungsplattform
- Verfügt über eine große Community und umfangreiche Dokumentation
- Ermöglicht programmierbare Workflows mit maximaler Flexibilität
- Hat ein reichhaltiges Ökosystem an Operatoren und Integrationen
- Skalierbarkeit
(Einfacherer) Extract & Load Fokus
- Stellt vorgefertigte Konnektoren für verschiedenste Datenquellen bereit
- Bietet eine benutzerfreundliche UI für die Konfiguration von Datenflüssen
- Erlaubt schnelle Implementierung von E/L-Prozessen ohne tiefe Programmierkenntnisse
- Unterstützt inkrementelle Datenerfassung und Synchronisation
- Lässt sich nahtlos mit dem gewählten Orchestrator integrieren
Transform Fokus
- Spezialisiert auf Transformationen
- Fördert modulare und testbare Transformationslogik
Einodnung der Tools in die Klassen:
| Tool-Klasse → | ETL/ELT Orchestrator | Extract & Load Fokus | Transform Fokus |
|---|---|---|---|
| Tool ↓ | Apache Airflow | Airbyte | DBT (neu, aber etabliert für deklarative Transform Aufgaben) |
| Dagster | NiFi | teilweise (Airbyte, NiFi) | |
| Windmill | |||
| ArgoCD Workflows | |||
| MageAI | |||
Beispiel-Übersicht
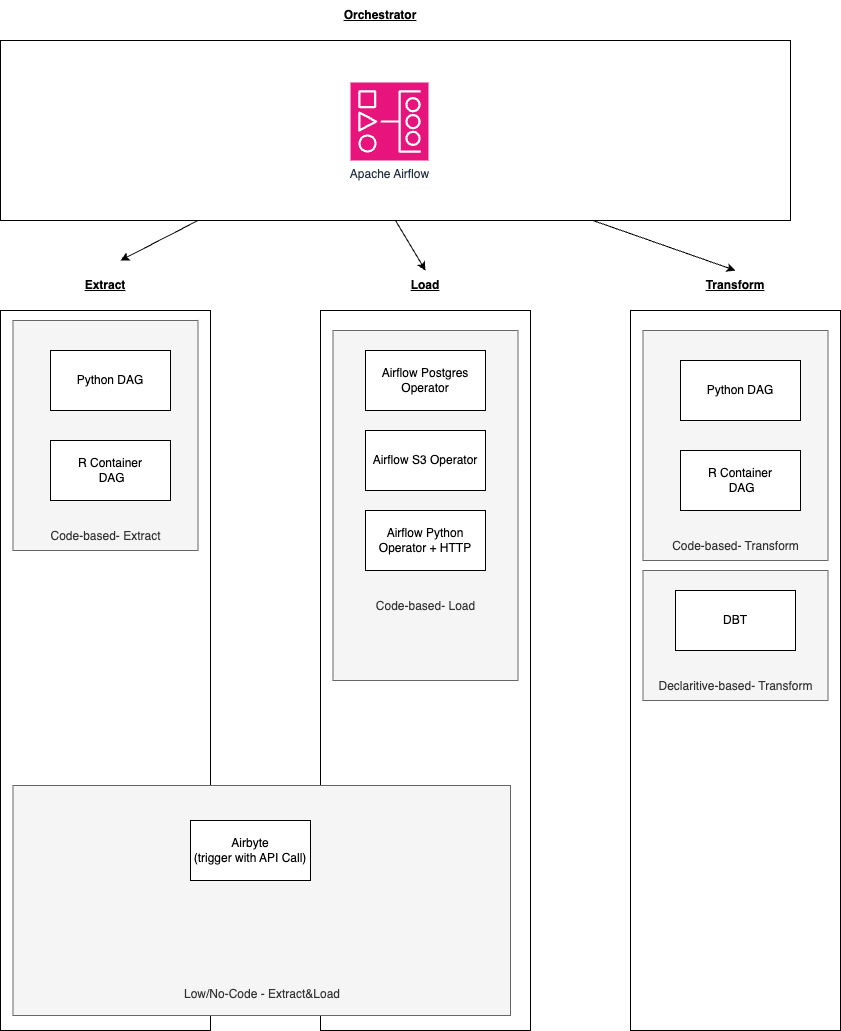
Argumentation: warum sollten zunächst zwei Orchestratoren verprobt werden?
Da die Anforderungslage im frühen Stadium der Datenfabrik Platform unklar sind sollen in Sprint 1 und Sprint 2 zwei Orchestratoren verprobt werden. Neben der Bewertungsmatrix soll hierbei vor allem die Reife der Software sowie der Funktionalitätsfokus eine Rolle spielen. Sowohl Windmill als auch MageAI sind deutlich neuere Projekte mit schwer-einschätzbarer Dynamik (Entwicklung der OpenSource Variante). Daher werden diese Tools verprobt:
- Airflow
- Dagster
Pro Airflow
- 100% OpenSource und etabliert mit genügend Dokumentation und beantwortete Fragen
- Hohe Anzahl an möglichen Operatoren
- Neues Airflow 3.0 release covered einige Pain Points, welche "next-gen" Orchestrator bisher covern wollten (e.g. Asset-based Focus) (https://medium.com/@Benjamin0313/getting-started-with-asset-based-scheduling-in-airflow-3-0-d1f00de93ffe)
Con Airflow
- Multi-Mandanten Setup durch RBAC nicht gegeben, muss anders gelöst werden
- Architektur "älter" und "monolithischer"
Pro Dagster (greift einige Pain Points von Airflow auf)
- Modernerer Ansatz "Deklarative Orchestration" und "Asset based"
- Bessere Mandanten und Workspace Trennung möglich
- Bessere Pipeline Analyse und Observability
- Bessere Data Lineage
Con Dagster
- Steile Lernkurve notwendig => Asset-based Ansatz etwas komplexerer
- Komplexeres Deployment Model (eigene Container je DAG/Projekt)
- Self-hosted hat nicht alle Funktionen
- Insb. Auth.& Oberservability
Empfehlung & Entscheidung
Entscheidung:
2025-05-07
- Für Sprint 1 wollen wir mit Dagster starten. Wir werden Dagster deployen und mit einem simplen Anwendungsfall verprobnen. In Sprint 2 werden wir Apache Airflow deployen und ein Vergleich anstreben.
PoC Fokus:
-
Mandantentrennung
-
Deploymentstrategie
- DAG / Teams (Repo)
- Können Entwickler lokal gut testen?
-
Möglichkeiten in UI je Team (self-service) VS. Operator-Need
- Berechtigung zu GitLab Setup
-
Auth